AI Server 退役和一般 Server 退役有什麼不同?企業 AI 基礎設施退役的 8 個關鍵風險
整理 GPU、HBM、NVMe、BMC、SmartNIC / DPU、序號追蹤、殘值、Chain of Custody 與 ESG 等 AI Server 退役關鍵風險。
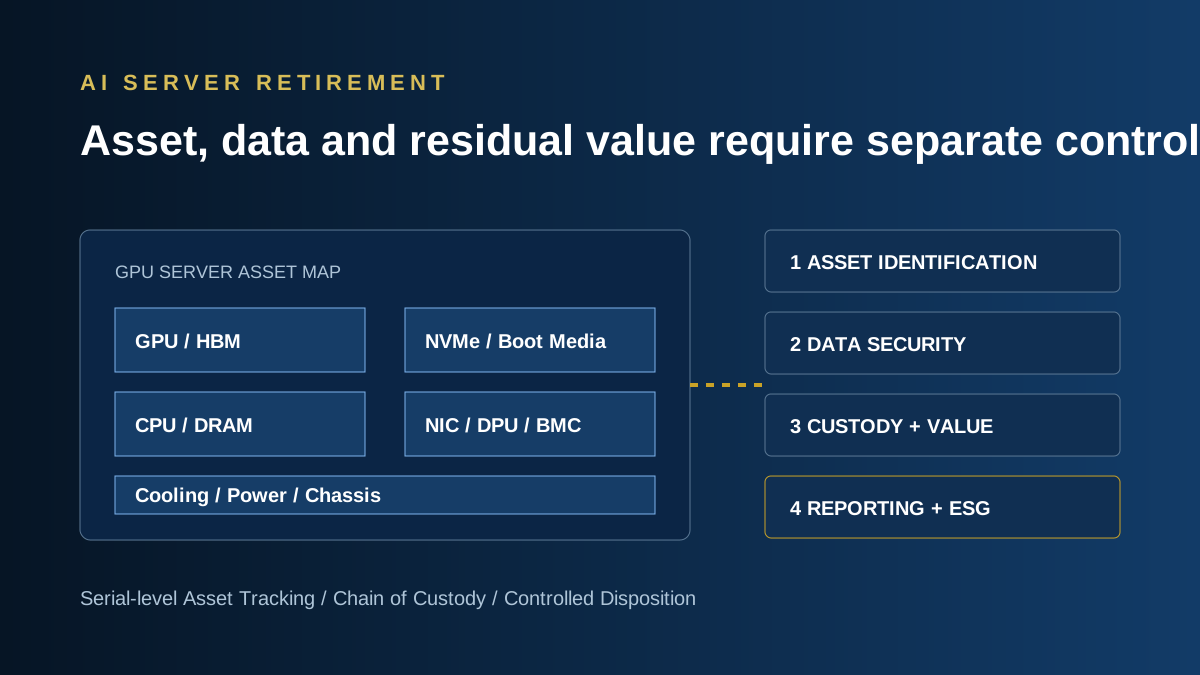
一般 Server 退役已經涉及資料、資產與機房協調;AI Server / GPU Server 又增加高價加速器、高密度 NVMe、BMC、SmartNIC / DPU、液冷與供電等複雜性。若仍把專案理解為「拆下硬碟、搬走機器」,企業可能同時失去資料控制、資產價值與可稽核證據。
AI Server retirement 的核心不是 destroying hard drives,而是 Asset Identification + Data Security + High-value Component Recovery + Chain of Custody + Residual Value Management + ESG / Circularity Reporting。
快速答案
AI Server 與傳統 Server 最大差異,不只是 GPU 價格。其資料可能分布在 NVMe、開機模組、BMC、網路卸載元件與外接儲存;高價元件又可能需要保留再利用。正確流程應先做配置與序號級盤點,再依元件的資料風險、所有權、狀況與市場條件決定再部署、抹除、拆分、銷售或破壞。
一般 Server 與 AI Server 退役比較
| 面向 | 一般 Server | AI / GPU Server |
|---|---|---|
| 高價元件 | CPU、DRAM、儲存與 NIC | GPU、HBM、NVMe、CPU/DRAM、NIC/SmartNIC/DPU,價值集中且波動較大 |
| 資料位置 | HDD/SSD、RAID、BMC、開機媒體 | 除一般位置外,可能有高密度 NVMe、DPU/SmartNIC、快取或專用模組 |
| 機房條件 | 標準機架、空冷與纜線 | 高功率、高重量、液冷、密集網路與特殊機架 |
| 殘值決策 | 整機或零組件再利用 | 常需元件級規格、序號、狀況與市場評估 |
| 文件 | 資產清冊、資料處理、運輸與結案 | 還需處理高價元件分流、拆分前後對應與更細緻的例外紀錄 |
風險一:資產清冊只記機箱,沒有記錄核心元件
一台 AI Server 可能包含多張 GPU、多顆 NVMe、CPU、DRAM、NIC / DPU、BMC 模組、電源與冷卻元件。若只記錄整機 asset tag,拆分後便難以說明哪一張 GPU、哪一顆 SSD 或哪個板件去了哪裡。專案應在可行範圍建立父子資產關係,記錄機箱與關鍵元件的序號、規格與狀況。
風險二:只處理主要 NVMe,忽略其他 data-bearing components
BMC 可能保留網路設定、帳號資訊或事件紀錄;開機媒體可能包含映像檔與憑證;SmartNIC 或 DPU 可能具備本地儲存、韌體與控制面設定。不是每一個元件都含有持久性客戶資料,但退役前必須先辨識,不能只依外觀看成「網卡」或「管理板」。
風險三:GPU 與 HBM 的資料風險被過度簡化
HBM 通常屬揮發性記憶體,斷電後不應被描述成與 SSD 相同的長期儲存媒體;但 GPU 系統仍可能因韌體、記憶體錯誤紀錄、主機映像、附屬儲存或整體系統狀態而需要控制。是否保留、測試或破壞 GPU,應依客戶政策、平台設計與資料路徑判斷,不能只因其價格高就忽略風險,也不能因擔心風險就一律破壞。
風險四:高價元件拆分後失去 Chain of Custody
GPU、NVMe 與 DPU 一旦離開原機箱,清冊必須同步更新。拆機人員、時間、位置、容器、封條、接收方與後續測試或處理結果,都應依專案要求留下紀錄。若 custody record 只到整機出場為止,後續元件分流會形成稽核斷點。
風險五:殘值評估早於所有權與資料處理決策
市場價格不能替代所有權確認與資料安全。企業應先確認資產可處分、租賃或保固限制、出口與合約條件,再決定 reuse、redeploy、secondary market 或 recycle。估值應註明配置、測試狀況、數量、交付時間與市場波動,不宜被描述為保證回收價格。
風險六:Data Center Decommissioning 的機電與場域條件不足
AI 機櫃可能重量高、功率密度大,並涉及液冷管路、冷卻液、busway、光纖與高速互連。退役計畫需要和資料中心營運、EHS、機電與資訊團隊確認停機授權、洩壓排液、斷電鎖定、搬運路徑與地板載重。ITAD 服務商不能自行假設有權操作仍在運行的基礎設施。
風險七:資料銷毀成功,但驗證與 exception log 不完整
批次處理時可能遇到無法上電、裝置鎖定、控制器故障、序號不一致或指令不支援。這些項目不應被合併成「全部成功」。流程需要定義 verification、validation 與 exception path,把失敗設備轉入核准的替代處理方式,並在報告中保留差異。
風險八:ESG 報告只寫重量,沒有說明資料邊界
AI Server 的 reuse、零件回收與材料回收可以形成循環利用成果,但 ESG 數字需要說明資料來源、估算方法、運輸與處理邊界。減碳效益應使用「估算」、「依現有資料推估」等語氣,不應把內部估算呈現為第三方查證結果。
建議的 AI Server 退役工作流
- 確認所有權、停機權限、服務範圍與場域限制;
- 建立機箱與 GPU、NVMe、NIC/DPU 等關鍵元件清冊;
- 辨識資料載體及需處理的設定、憑證或持久性記錄;
- 核准 on-site / off-site、清除、破壞、再部署與回收路徑;
- 執行拆機、包裝、封存與安全運輸;
- 驗證資料處理結果並管理例外;
- 依條件執行 high-value component recovery 與 residual value disposition;
- 交付 Chain of Custody、序號清冊、Certificate of Destruction、資產處分與 ESG 摘要。
相關服務
參考資料
本文提供一般性規劃框架,不代表每一種 AI Server 都含有相同元件或適用相同處理方式。實際專案應依設備 BOM、原廠文件、資料政策、場域與合約要求確認。
常見問題
AI Server 退役是否只要處理 NVMe SSD?
不是。除了主要儲存裝置,還應檢查開機媒體、BMC 設定、SmartNIC 或 DPU、可移除模組及其他可能保留資料或憑證的元件。
GPU 與 HBM 一定要實體破壞嗎?
不一定。應先確認資料持久性、設備狀態、客戶政策與再利用條件。高價元件的處置應把資料風險與資產價值分開評估。
AI Server 殘值如何納入 ITAD?
應在所有權、序號、規格、狀況、資料處理與市場條件確認後,再評估再部署、備品、二級市場或材料回收路徑。
與 KYI 規劃下一步
企業 IT 資產退役或資料銷毀需求,歡迎與 KYI 聯繫。
聯絡 KYI →